AIが2週間で数学の論文719本。OpenAIはリーマン予想を解いたのか、全372件を数えてみた
OpenAIが、社内の未公開AIが書いた数学の論文719本を一度に公開しました。目玉は「準リーマン予想」の証明という主張です。では、160年以上解けていないリーマン予想は、ついに解けたのか。答えは「いいえ。でも、手前の大きな一歩かもしれない」。全372件を自分たちで数え直すと、コンピューターで証明を確かめられたのは36%、反例で予想をくつがえした成果が約2割、ページ数は3万4,000を超えていました。
 DATA WORLD編集部
特集 15分

数学には、100年以上だれにも解けていない問題がいくつもあります。その代表が「リーマン予想」。素数の並び方の秘密に関わる予想で、解いた人には100万ドルの懸賞金がかかっています。
2026年10月6日(日本時間7日)、OpenAIが、その周りの問題を含む数学の論文719本を、一度に公開しました。書いたのは、社内でまだ公開していないAIのモデルです。目玉は「準リーマン予想を証明した」という論文。SNSには「リーマン予想が解けた?」という声があふれました。
私たちは先週、論文が増えすぎて投稿サイトarXivが「1人月2本まで」の制限を始めた話を書いたばかりです。そこへ今度は、AIが一度に719本。正直、数字を見た瞬間に「読めるの、これ?」と思いました。
そこで、公開された一覧とデータを自分たちで数え直しました。先に答えを書くと、こうです。
- リーマン予想は、解けていない
証明したと主張しているのは、手前の「準リーマン予想」。論文自身が「リーマン予想は未解決のまま」と書いています。 - ただ、本当なら手前の大きな一歩
ゼータ関数の「零点」が、実部7/8より右には1つもない。これまで、だれも示せなかった種類の結果です。 - 確かめられたのは、まだ一部
証明をコンピューターで確かめた成果は、全372件の36%。翌日には3本が撤回されました。
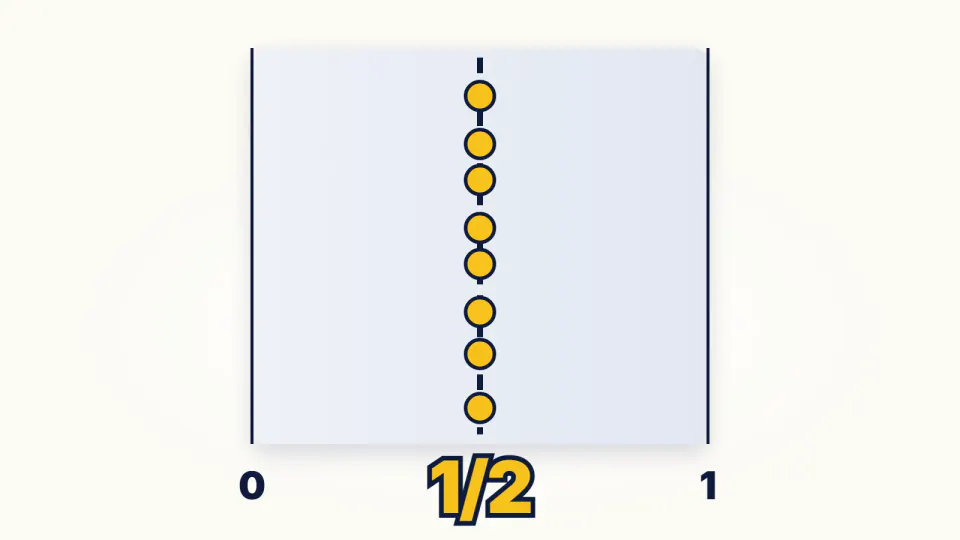
リーマン予想
ゼータ関数が0になる点は、すべて「1/2」の線の上に並ぶ。素数の並び方に関わる、数学最大級の未解決問題
- 1859リーマンが予想素数の数え方と、ゼータ関数の「0になる点」を結びつける
- 1896素数定理の証明実部1の線の上には、0になる点がないと示される
- 2000100万ドルの懸賞問題クレイ数学研究所が7つの難問の一つに選ぶ
- 20213兆の高さまで確認コンピューターで調べた範囲の点は、すべて線の上
- NOWOpenAIが「7/8」を主張線の手前で、0にならない範囲を広げたと発表
リーマン予想は、クレイ数学研究所が2000年に選んだ7つの「ミレニアム懸賞問題」の一つです。素数がどれくらいの割合で現れるかを、どこまで正確に言えるかが、この予想にかかっています。
コンピューターでは、すでに膨大な数の「0になる点」が調べられています。2021年には、高さ3兆までの点がすべて予想どおりの線の上にあることが確かめられました。それでも、無限にある点のすべてについて証明できた人は、まだいません。
OpenAIの数学の論文719本、4つの疑問に先に答えます
リーマン予想は解けていない。手前の一歩を主張し、確かめる作業はこれから
AIが2週間で書いた、3万4,000ページ
OpenAIは今回、GitHubに数学の原稿を置きました。公開したときは722本で、翌日に3本を撤回して、いまは719本です。似たテーマの原稿をまとめた「成果」の単位で数えると372件。ほとんどが、社内の未公開モデルの出した結果です。
説明によると、モデルに出した問題は約4,000問。考えさせた時間は、1つの成果あたり平均で、ChatGPT Proの3時間ぶんの計算でした。4,000問から、意味のある成果としてまとめられたものが372件、という計算になります。
原稿の量も、私たちで数えました。PDFのページ数を合計すると、約3万4,600ページ。1本あたりの平均は48ページで、いちばん長いものは262ページあります。数学の専門家が1日50ページずつ読んでも、全部読むには2年近くかかります。
しかも、原稿の日付を見ると、719本の99%が、9月23日から10月7日のあいだの日付です。人間の数学者なら1本に何か月もかける長さの論文が、2週間ほどのあいだに、まとめて書かれたことになります。
解いたと主張するのは、手前の「準リーマン予想」
まず、いちばん気になる問いから。リーマン予想は、解けていません。
これは私たちの判断ではなく、OpenAIの論文自身が書いていることです。準リーマン予想の論文は、序論で「この定理はリーマン予想を確立しない。リーマン予想は未解決のまま」と明記しています。
では、何を証明したと言っているのか。ここからは、なるべく式を使わずに説明します。
ゼータ関数の「0になる点」を、地図で考える
リーマン予想の主役は、「ゼータ関数」という関数です。この関数は、平面の上の地図のように考えられます。地図の上のそれぞれの地点に、値が1つ決まっている。その値が0になる地点を「零点(れいてん)」と呼びます。
地点の横の位置を「実部」と言います。調べてみると、大事な零点は、横の位置が0から1までの帯の中にしか現れません。この帯の、ちょうど真ん中の線(実部1/2)に、零点がすべて並んでいるはずだ。これがリーマン予想です。
なぜ、零点の位置がそんなに大事なのか。零点が真ん中の線から右にずれているほど、素数の数え方の誤差が大きくなるからです。リーマン予想が正しければ、素数がどこまでにいくつあるかを、とても小さな誤差で言い当てられます。
これまで言えたのは「右の端の、すぐそば」だけ
1896年に証明された「素数定理」は、帯の右の端、実部1の線の上に零点がないことを示しました。その後も、右の端のすぐそばには零点がないことが示されてきました。
ただし、その「零点がない幅」は、地図を上へ行くほど細くなっていきます。上のほうでは、右の端にどこまでも近い場所に零点があるかもしれない。「この線より右には、1つもない」と言える、まっすぐな線は、だれも引けていなかったんです。その線を引けるか、という問題が「準リーマン予想」です。

OpenAIの論文が主張するのは、ゼータ関数は実部7/8より右に零点を持たないということです。上へ行っても細くならない、まっすぐな線を、7/8の位置に引いたことになります。ゼータ関数の仲間(ディリクレのL関数)にも、同じことが言えるとしています。
SNSでは「7/8」と「11/12」という2つの数字が出回り、混乱もありました。原稿を読むと、理由は単純です。199ページの論文は2部に分かれていて、前半で11/12の線を引き、後半でそれを7/8まで押し込んでいます。11/12は、7/8にたどり着くための途中の段階なんです。
本当なら、どれくらいすごいのか。応用数学者のジョン・D・クックさんは、ブログで、この結果から素数の数え方の誤差がどこまで小さく言えるかを計算しています。これまでの誤差の見積もりから、はっきり一段よい形になります。チリ・カトリック大学の数学者エクトル・パステンさんは、Scientific Americanの取材に、準リーマン予想は多くの応用にとって十分すぎるほどだと話しています。
とはいえ、7/8と1/2のあいだには、まだ広い幅が残っています。リーマン予想まで、あと「7/8から1/2まで」の距離。そこを埋める道筋は、今回の論文からはまだ見えていません。
全372件を数えた。2割は「予想をくつがえす」成果
準リーマン予想は、372件のうちの1件にすぎません。ほかに何が入っているのか、一覧を全部数えました。
成果は、17の分野に分かれていました。件数がいちばん多いのは、計算の速さや難しさを扱う理論計算機科学で40件。組合せ論が37件、代数幾何・複素幾何が36件、数論が31件と続きます。原稿の本数でいえば、確率論・統計力学が105本でいちばん多く、1つの成果に何本もの原稿が連なっていました。
名前を聞いたことがある問題も、たくさん並んでいます。
- 円周率の「無理数らしさ」は、ちょうど2
円周率が分数でどれだけうまく近似できるかを表す数を、2だと決めたという主張。日本の数学者のブログINTEGERSは、これまでの上限が約7.1だったと紹介し、いちばん感情を揺さぶられた結果に挙げています。 - 行列のかけ算が、さらに速くなる
AIの計算の中心でもある行列のかけ算の手間を表す指数を、約2.37から9/4(2.25)まで下げたという主張。 - ヒルベルトの第10問題の、有理数の版
方程式に分数の解があるかどうかを、必ず判定できる手順は存在しない、と示したという主張です。
もう一つ目立ったのが、予想を「くつがえす」成果です。説明文が「反証する」「反例を作る」で始まるものや、題名に「反例」を含むものを数えると、372件のうち70件、約2割が「その予想は成り立たない」という答えでした。グラフの塗り分けに関する有名な「ハドウィガー予想」に反例を作ったという主張も、その一つです。
そして、372件のうち205件(55%)は、原稿が1本だけの成果でした。残りは、1つの成果に2本から14本の原稿が連なっています。大きな成果ほど、補助の定理や別の証明を何本も積み重ねている形です。

コンピューターで確かめられたのは36%
これだけの量の証明を、だれが確かめるのか。今回、OpenAIが頼りにしているのが「Lean(リーン)」です。
準リーマン予想については、証明すべき主張がLeanでたった2行で書かれています。「複素数sの実部が7/8より大きければ、ゼータ関数の値は0ではない」。この2行は、数学者なら読めばすぐに意味が分かります。あとは、この2行に対する長い証明を、コンピューターが最後まで受け付けるかどうか。人間は短い主張だけを確かめ、長い証明はコンピューターに任せる、という分担です。
ただ、すべての成果がこの形になっているわけではありません。Leanの一覧に、主な結果の形式化が登録されている成果を数えると、372件のうち135件、36%でした。OpenAIは「主な結果の約42%を形式化した」と書いていますが、これは300を原稿の数719で割った数字で、私たちの数え方とは分子も分母も違います。
分野で比べると、差ははっきりしています。

数理論理学は6件中5件、関数解析は11件中8件。一方、図形のつながり方を扱うトポロジーは18件中1件、代数幾何は36件中7件でした。Leanのライブラリに道具がそろっている分野ほど、確かめやすいのかもしれません。少なくとも数字からは、「コンピューターでの確かめやすさ」が、分野によって大きく違うことが見えてきます。
残りの6割強は、人間が読んで確かめるしかありません。そして、そこで早くも誤りが見つかりました。公開の翌日、OpenAIは3本の原稿を撤回しました。ホッジ予想に関わる原稿の符号の誤りが、それを使う2本にも響いていたためです。同じ日に、ほかの14本の証明も直しています。3本は、公開した日のLeanの一覧にも載っていない、コンピューターで確かめていない原稿でした。
Leanにも限界はあります。コンピューターが確かめるのは、あくまで「Leanで書いた主張」です。それが論文の日本語や英語の主張と本当に同じかは、人間が見ないと分かりません。英ケンブリッジ大学とキングス・カレッジ・ロンドンの数学者は、先に発表されたナビエ・ストークス方程式の成果について、論文の文章とLeanのコードに少なくとも2か所の食い違いを見つけたと報告しています。OpenAIのLeanの一覧自体も、人によるレビューの状態は「未確認」のままです。
数学者の反応は、絶賛と批判に割れた
数学者の反応は、大きく割れています。
評価する声から。先ほどのパステンさんは、ヒルベルトの第10問題の成果の進め方を「独創的」と評しました。トロント大学のダン・リットさんは、Fortuneに「これは数学にとって素晴らしいこと」だと話しています。ただし、「AIが数学を解き終えた」と受け取られて、研究費が減ることを心配してもいます。
厳しい声も強く出ています。フィールズ賞の受賞者で、カリフォルニア大学ロサンゼルス校のテレンス・タオさんは、AIに問題を出した人たちが、答えについて質問に答えられるほど中身を理解していないと指摘しました。ハーバード大学のメラニー・ウッドさんも、公開の時点では人間の理解がない、仕事はそこから始まる、と話しています。
「Association for Human Mathematics(AHM)」という団体は、「数学者がこの仕事を頼んだわけではない」とする声明を出しました。700本を超える原稿は、学問の成果ではなく「力の誇示」だとまで書いています。
批判の多くは、証明が正しいかどうかより、出し方に向いています。OpenAIが意見を聞いた高等研究所の助言グループは、9月末の提言で、モデルの名前や指示文、計算の費用などを明らかにすることを求めていました。今回、考えた過程の要約が公開されたのは10件だけです。助言グループは、提言が守られたかの判断は数学の世界にゆだねるとしています。
足りなくなったのは「解く力」より「確かめる力」
372件を数え終えて残ったのは、リーマン予想の行方より、もっと身近な問いでした。
3万4,000ページを、だれが読むのか
AIは2週間で、3万4,000ページを書きました。人間の専門家が全部を読むには、何年もかかります。arXivが投稿に上限をかけたのも、読む人の時間が足りなくなったからでした。
書く速さと、読んで確かめる速さの差が、ここまで開いた。翌日の撤回3本は、その差がそのまま表に出たものだと思います。これからの研究で足りなくなるのは、答えを出す力より、答えを確かめて理解する人の時間なんですよね。
2行の主張と、機械の検算
それでも、希望も見えました。準リーマン予想のように、主張を2行に絞り、長い証明はコンピューターが確かめる。この形なら、人間は2行を読むだけで、結果を信じるかどうかを判断できます。
これは数学に限った話ではありません。AIに書かせたプログラムや報告書を受け取るとき、私たちも「何を確かめれば信じてよいか」を先に決めておく必要があります。AIに仕事を頼むときは、答えと一緒に「確かめ方」も設計する。Leanの2行は、そのいちばんきれいな見本に見えました。
SOURCES ── 出典・参考
- OpenAI『Sharing AI progress in mathematics』(2026年10月6日)
- OpenAI『openai/math』GitHubリポジトリ(README、CONTENTS.md、history.md、lean/formalization.yaml。2026年10月8日の版を集計)
- OpenAI『history.md』(2026年10月7日の撤回と修正の記録)
- OpenAI『The Quasi-Riemann Hypothesis: A Zero-Free Half-Plane Re(s)>7/8』(2026年9月30日付の原稿)
- OpenAI『The quasi-Riemann hypothesis(Leanの形式化の範囲)』
- OpenAI『QuasiRiemannHypothesis.lean』(Comparatorで照合する主張)
- Scientific American『The most exciting claims from OpenAI's heap of new proofs』(2026年10月8日)
- Fortune『OpenAI publishes solutions to more than 370 outstanding math challenges. Math may never be the same』(2026年10月7日)
- TechCrunch『OpenAI's math solutions aren't meeting the field's standards yet』(2026年10月8日)
- Association for Human Mathematics『AHM Statement on OpenAI's October 6 Release of Mathematical Documents』(テレンス・タオのブログに掲載、2026年10月7日)
- INTEGERS『OpenAI社が10/7に公開した問題の中で私がとりあえず驚いた結果の紹介』(2026年10月7日)
- John D. Cook『Consequences of progress toward the Riemann Hypothesis』(2026年10月7日)
- クレイ数学研究所『Riemann Hypothesis』(ミレニアム懸賞問題)
- Platt & Trudgian『The Riemann hypothesis is true up to 3·10^12』(Bulletin of the London Mathematical Society、2021年)


